

Чтобы обучить модель обнаружения мошенничества, нужны сотни тысяч примеров транзакций — в том числе мошеннических. Взять их напрямую из базы реальных клиентов и передать разработчикам или сторонним подрядчикам для тренировки модели — значит нарушить закон о персональных данных и банковскую тайну. Синтетические данные решают эту дилемму иначе: банк генерирует искусственные, но статистически правдоподобные «виртуальные» транзакции, на которых можно обучать и тестировать модель, не подвергая риску ни один реальный клиентский счёт. Разбираем, как это устроено технически и где у подхода есть реальные ограничения.
Что такое синтетические данные
Синтетические данные — это информация, сгенерированная алгоритмом, а не собранная напрямую из реального мира. В отличие от деидентифицированных данных, где из реальной записи просто удаляют или маскируют идентифицирующие поля (имя, номер карты, адрес), синтетические данные с самого начала не связаны ни с одним конкретным реальным человеком — это полностью искусственно созданный набор, статистически воспроизводящий структуру и закономерности оригинальных данных, но не содержащий ни одной подлинной записи о реальном клиенте.
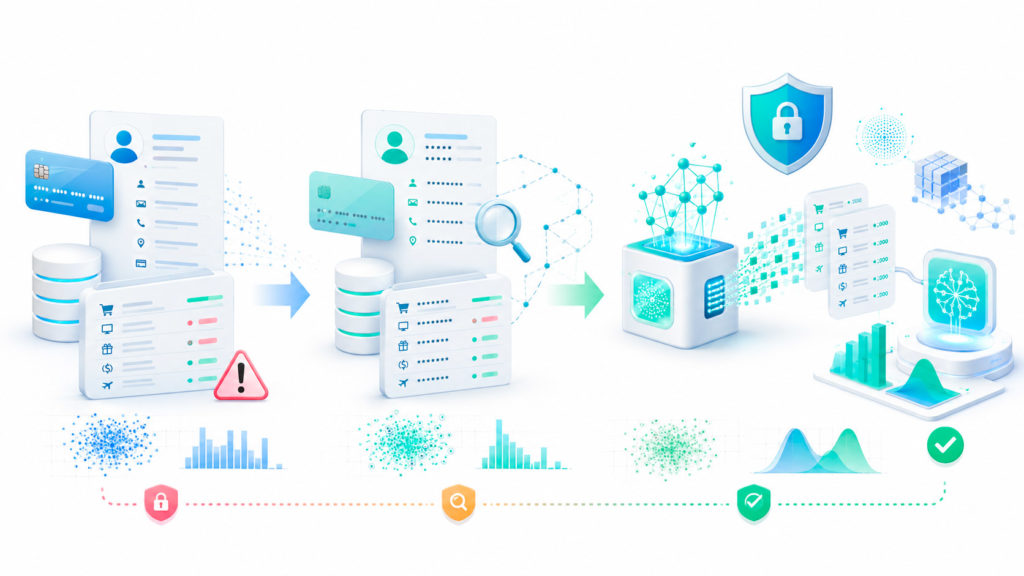
Таблица 1. Три подхода к работе с чувствительными данными
| Подход | Что происходит | Основной риск |
|---|---|---|
| Реальные данные | Используются подлинные записи о клиентах | Прямое нарушение законодательства о персональных данных при передаче третьим лицам |
| Деидентифицированные данные | Из реальных записей удаляют явные идентификаторы | Риск повторной деанонимизации при сопоставлении с другими источниками |
| Синтетические данные | Данные полностью генерируются алгоритмом с нуля | Модель может не полностью воспроизвести редкие закономерности реальных данных |
Зачем это нужно именно банкам
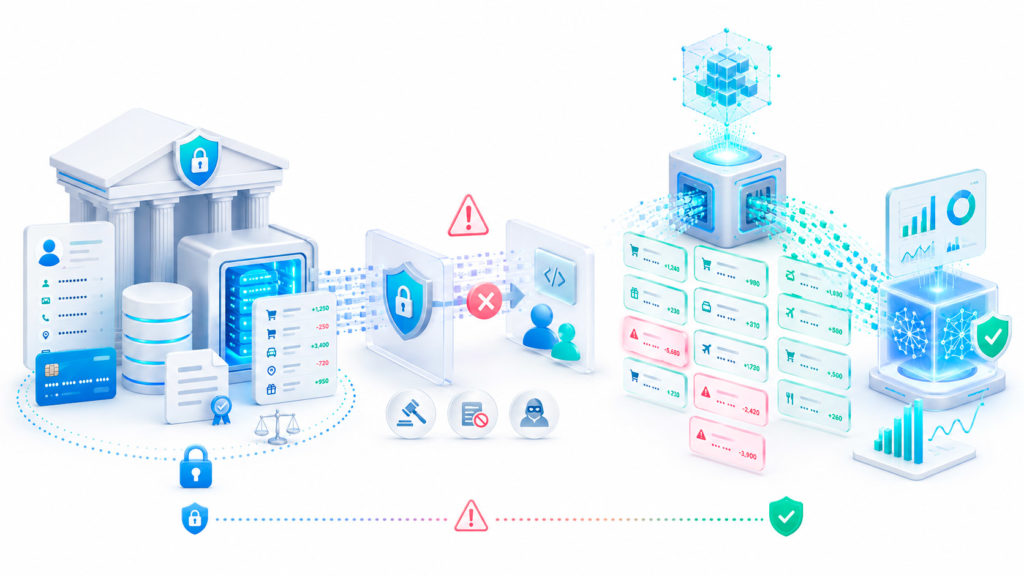 Финансовые данные — один из самых зарегулированных типов информации, наряду с медицинскими записями: любая база транзакций клиентов подпадает под требования законодательства о персональных данных (в России — 152-ФЗ) и режим банковской тайны, что делает её передачу даже внутри собственной организации, не говоря уже о внешних подрядчиках или партнёрах, юридически рискованным шагом без специальной подготовки данных. При этом реальные данные считаются золотым стандартом для анализа именно потому, что синтетическая замена рискует упустить какие-то неочевидные закономерности реального мира, — однако доступ к подлинным данным часто оказывается затруднён, дорог или напрямую ограничен регулированием, что и создаёт практический спрос на синтетическую альтернативу.
Интересный факт: классическая архитектура GAN, лежащая в основе значительной части современных технологий генерации синтетических данных, была впервые описана исследователем Яном Гудфеллоу в компании Google лишь в 2014 году, — то есть вся эта область банковских технологий моложе большинства продуктов, которые она сегодня помогает обучать и защищать.
Показательный пример практического применения: банк может сгенерировать синтетические транзакции для тестирования моделей обнаружения мошенничества, не используя при этом ни одного реального клиентского счёта, — причём в отличие от реальных данных, где мошеннических примеров объективно меньшинство, синтетический генератор способен создать сколько угодно правдоподобных примеров именно мошеннического поведения, включая крайне редкие в реальной статистике сценарии, обучение на которых иначе потребовало бы дожидаться накопления достаточного числа реальных инцидентов. Похожая логика работы с редкими, но критически важными случаями применяется и в системах, которые непосредственно выявляют мошенничество в реальном времени, — подробнее о том, как устроена эта параллельная линия защиты, можно прочитать в материале «как машинное обучение ловит банковских мошенников».
Как технически генерируют синтетические данные
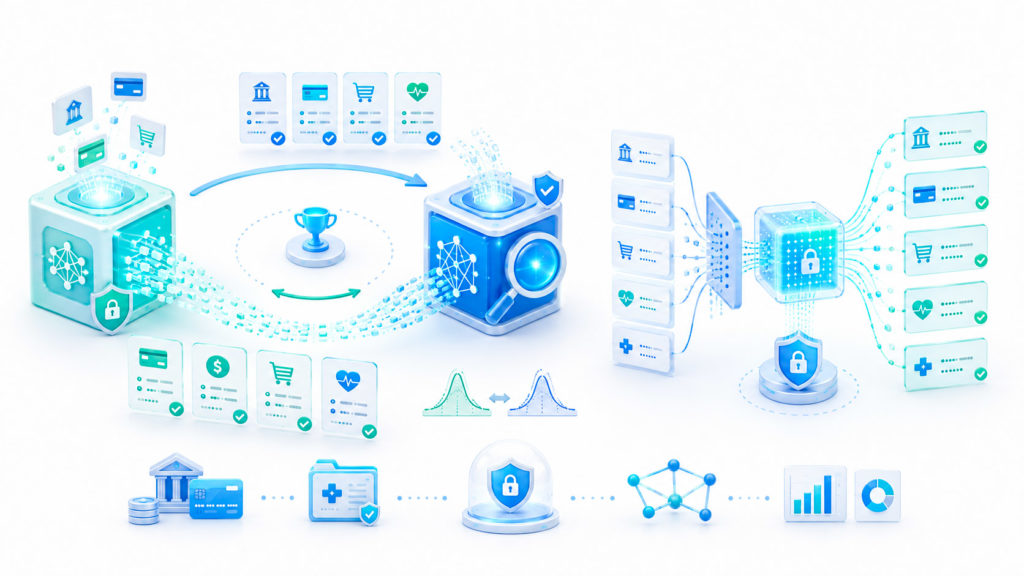 Одна из основных технологий, лежащих в основе современной генерации синтетических данных, — генеративно-состязательные сети (GAN, generative adversarial network), впервые описанные исследователем Яном Гудфеллоу в 2014 году. Архитектура GAN построена на противостоянии двух нейросетей с противоположными целями: одна сеть (генератор) учится создавать образцы данных, максимально похожие на настоящие, а вторая сеть (дискриминатор) учится отличать созданные генератором образцы от подлинных. Классическая аналогия, которую используют для объяснения этого принципа, — фальшивомонетчик и полицейский: задача фальшивомонетчика — научиться подделывать купюры так, чтобы полицейский не смог их отличить от настоящих, а задача полицейского — научиться безошибочно отличать подделку. По мере того как обе сети соревнуются друг с другом, генератор постепенно учится создавать всё более убедительные, статистически правдоподобные искусственные данные.
Помимо GAN, для генерации синтетических данных также применяются вариационные автокодеры (VAE) — альтернативный класс генеративных моделей, которые сжимают исходные данные в компактное скрытое представление, а затем восстанавливают из него новые, синтетические образцы с похожей статистической структурой. В медицине, где та же проблема доступа к чувствительным данным стоит не менее остро, чем в банкинге, похожий подход реализован в проекте MedGAN, разработанном в Массачусетском технологическом институте ещё в 2018 году, — система создаёт медицинские записи, статистически неотличимые от настоящих, но не содержащие данных ни одного реального пациента.
Где именно синтетические данные уже применяются в банковской практике
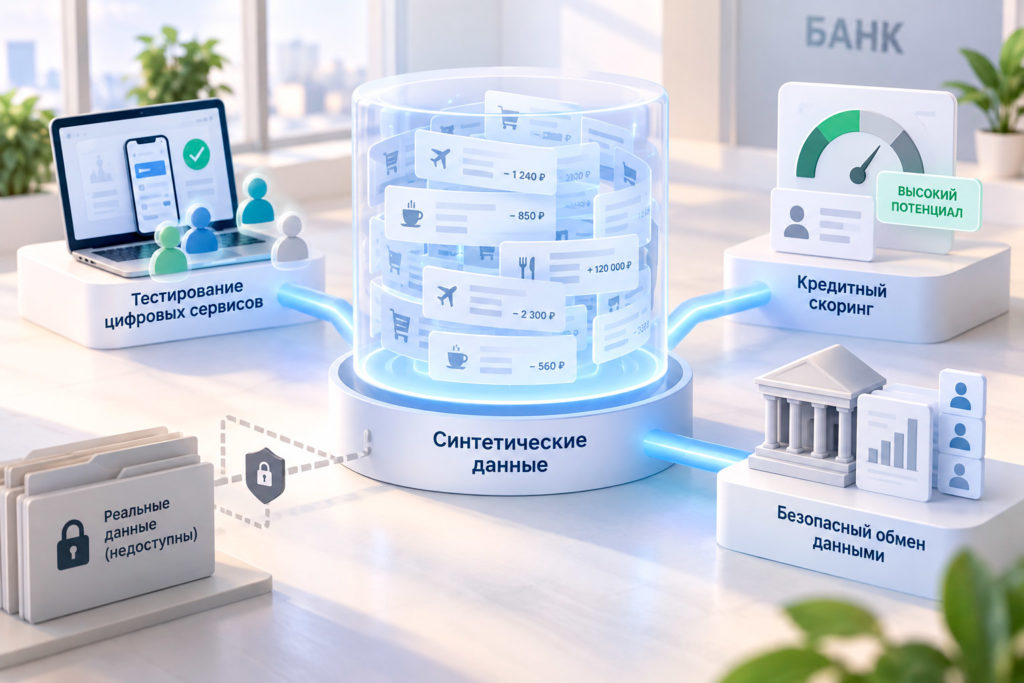 Помимо тестирования антифрод-моделей, синтетические данные закрывают в банковской практике ещё несколько конкретных задач:
- тестирование новых цифровых сервисов в изолированном контуре. Прежде чем выкатить новую функцию или систему на реальных клиентов, её можно протестировать на синтетических пользователях, поведение которых статистически похоже на настоящих клиентов, но не связано с реальными людьми;
- обучение моделей кредитного скоринга при дефиците реальных примеров. Для новых кредитных продуктов или редких сегментов заёмщиков, по которым банк ещё не накопил достаточного объёма собственной статистики, синтетическая генерация позволяет дополнить обучающую выборку правдоподобными примерами, сохраняя статистические закономерности, характерные для похожих реальных сегментов;
- обмен данными между организациями без риска раскрытия персональной информации. Синтетические датасеты позволяют делиться репрезентативной статистикой с партнёрами, регуляторами или исследовательскими подразделениями без передачи реальных сведений о конкретных клиентах.
Похожая логика применения технологии для решения задачи при ограниченном объёме реальных, юридически чувствительных примеров используется и в других направлениях банковского ИИ — в частности, в системах оценки кредитоспособности заёмщика, где модель должна одинаково надёжно работать и на типичных, и на редких профилях клиентов. Подробнее об этом можно прочитать в материале «нейросеть определяет заёмщика: как устроен кредитный скоринг на ИИ».
Реальные ограничения технологии
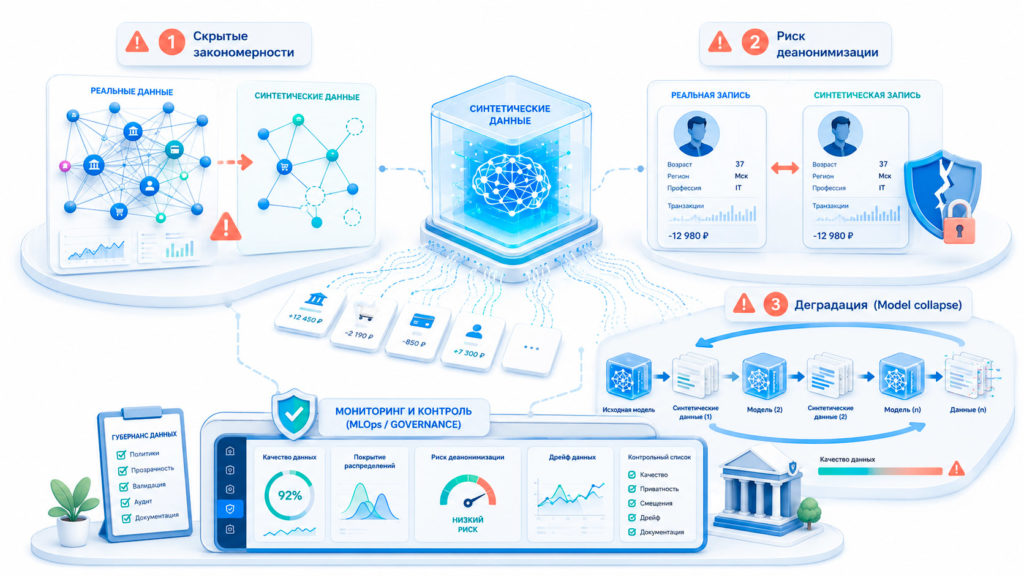 Несмотря на растущую популярность подхода, у синтетических данных есть вполне конкретные технические ограничения, которые отраслевые эксперты не рекомендуют игнорировать:
- риск упустить неочевидные закономерности реального мира. Реальные данные остаются золотым стандартом именно потому, что содержат подлинные, иногда неожиданные взаимосвязи, которые генеративная модель, обученная на ограниченной выборке исходных примеров, способна не воспроизвести или упростить;
- теоретический риск повторной деанонимизации. Если генеративная модель переобучилась на слишком узком наборе исходных данных, синтетические образцы способны непреднамеренно оказаться слишком близкими копиями конкретных реальных записей — формально это уже не полностью «синтетические», а фактически замаскированные подлинные данные, что подрывает саму цель подхода;
- риск деградации при рекурсивном обучении на синтетике. Отраслевые исследователи всё активнее обсуждают эффект, при котором модели, обучаемые преимущественно на данных, сгенерированных другими моделями, а не на исходных реальных данных, со временем накапливают и усиливают собственные артефакты и искажения — этот эффект в англоязычной литературе получил название model collapse и является предметом активных исследований, а не решённой инженерной задачей.
По данным отраслевых обзоров, синтетический медицинский проект MedGAN, разработанный в Массачусетском технологическом институте ещё в 2018 году, создаёт записи о пациентах, статистически неотличимые от настоящих, но не содержащие данных ни одного реального человека, — подход, концептуально идентичный тому, что банки сегодня применяют для генерации искусственных клиентских транзакций.
По оценке зарубежных аналитических компаний, до 85% ML-проектов в целом не доходят до полноценного продакшена, и одной из главных причин этому называют не качество самих алгоритмов, а отсутствие зрелых практик управления жизненным циклом модели (MLOps) — синтетические данные способны облегчить именно этап получения обучающей выборки, но не отменяют необходимости выстраивать вокруг модели полноценную инфраструктуру мониторинга и контроля качества.
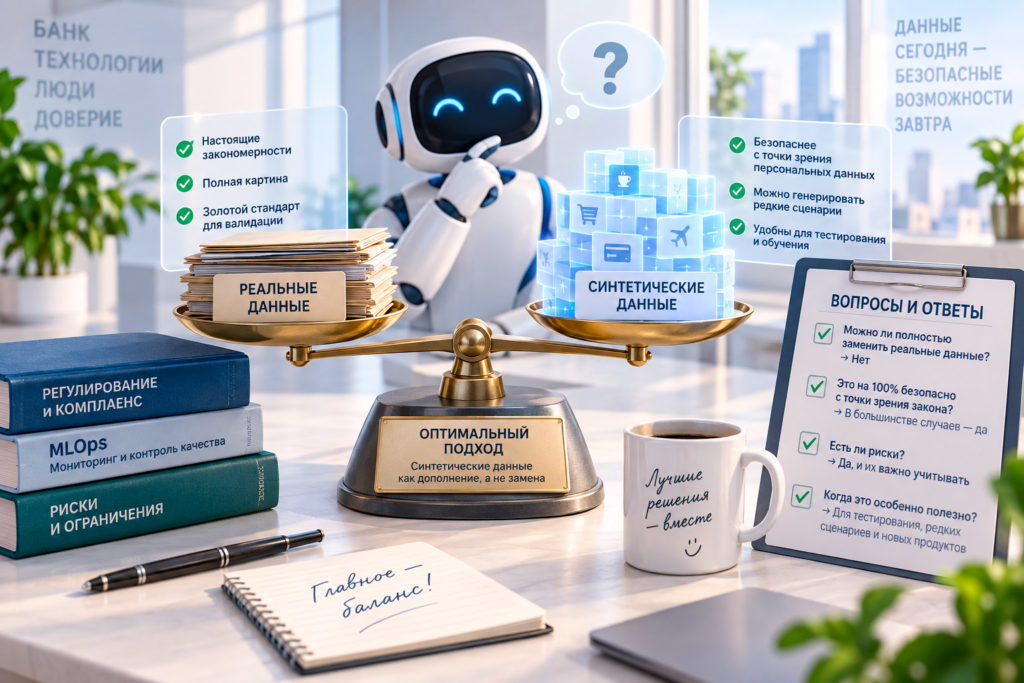
- Можно ли полностью заменить реальные банковские данные синтетическими? Нет, отраслевые эксперты не рекомендуют полный переход на синтетику: реальные данные остаются золотым стандартом для итоговой валидации модели именно потому, что содержат подлинные закономерности реального мира, которые генеративная модель способна не полностью воспроизвести. Синтетические данные чаще применяются как дополнение к ограниченному объёму реальных данных, а не как их полная замена.
- Безопасны ли синтетические данные с точки зрения закона о персональных данных на сто процентов? В подавляющем большинстве случаев да, поскольку синтетические записи изначально не связаны ни с одним конкретным реальным человеком. Теоретический риск сохраняется только в случае, если генеративная модель переобучилась на слишком узкой и специфичной исходной выборке и начала производить образцы, слишком близко копирующие конкретные реальные записи, — качественная методология генерации синтетических данных должна исключать подобный сценарий на этапе проверки результата.


