

Подключить готовую нейросеть через API стороннего вендора можно за недели. Обучить собственную модель с нуля — это годы работы, сотни специалистов и бюджеты, которые банки предпочитают не называть напрямую. Тем не менее крупнейшие банки один за другим выбирают именно второй, более дорогой путь. У этого решения есть три вполне рациональные причины, и ни одна из них не сводится к желанию выглядеть технологичнее конкурентов.
На практике у банка есть не два, а три реальных пути, и у каждого своя логика.
Таблица 1. Три стратегии внедрения ИИ в банке
| Стратегия | Контроль над данными | Скорость запуска | Типичный выбор |
|---|---|---|---|
| Готовое решение вендора (API) | Минимальный — данные уходят во внешний контур | Недели | Небольшие и средние банки, непрофильные задачи |
| Дообучение открытой модели (fine-tuning) | Средний — модель развёрнута в контуре банка, но архитектура чужая | Месяцы | Банки среднего масштаба, специфичные задачи без огромного бюджета |
| Разработка модели с нуля | Полный — банк владеет всей архитектурой и данными обучения | Годы | Банки федерального масштаба (Сбер, Т-Банк) |
Данные клиента не должны покидать периметр банка
 Первая и самая весомая причина — это данные. Банк обрабатывает информацию, которая относится к банковской тайне и персональным данным клиентов: остатки на счетах, историю операций, кредитную нагрузку. Отправлять такие данные во внешний API стороннего вендора, даже надёжного, означает создавать дополнительную точку риска, за которую банку всё равно придётся отвечать перед регулятором и клиентом.
Собственная модель, развёрнутая в контуре банка, снимает этот риск в его самой острой форме: данные физически не покидают инфраструктуру, которую банк полностью контролирует. Это особенно важно на фоне того, что Банк России в 2026 году прорабатывает требования к так называемому «паспорту ИИ-модели» — формализованному описанию того, на каких данных модель обучена и как контролируется её поведение. Формировать такой паспорт для модели, которую банк не разрабатывал сам, а лицензировал у внешнего поставщика, заметно сложнее с юридической точки зрения. Подробнее о том, как регулятор в принципе смотрит на автономность ИИ в банковских процессах, — в материале «Банк без сотрудников: как ИИ меняет банковское обслуживание изнутри».
Универсальная модель хуже специализированной в конкретной задаче
 Вторая причина — качество результата. Готовая универсальная нейросеть неплохо справляется с общими задачами: суммаризацией текста, ответами на типовые вопросы. Но кредитный скоринг, антифрод и голосовая аналитика — это узкоспециализированные задачи, где цена ошибки модели измеряется в рублях конкретного невозвращённого кредита или пропущенного мошенничества.
Именно поэтому Т-Банк ещё в конце 2023 года публично отказался от идеи одной модели по образцу ChatGPT в пользу нескольких узкоспециализированных языковых моделей под разные продуктовые сценарии — отдельно для кредитования, отдельно для поддержки клиентов, отдельно для антифрода. Логика простая: специализированная модель, обученная на данных конкретной задачи банка, статистически точнее универсальной модели общего назначения в этой же задаче, даже если формально уступает ей в широте возможностей. Как эта специализация выглядит на практике в задаче кредитного скоринга — разбираем в материале «как устроен кредитный скоринг на ИИ».
Технология как продукт, а не только как внутренний инструмент
Третья причина менее очевидна, но не менее рациональна: для банков вроде Сбера собственная модель — это не только внутренний инструмент, но и самостоятельный продукт. GigaChat развивается не просто как чат-бот для клиентов банка, а как отдельная платформа, которую банк предлагает внешним разработчикам и компаниям, включая GigaChat Business для бизнес-клиентов.
Здесь экономика совершенно другая, чем при простой покупке лицензии у стороннего вендора: банк, владеющий моделью целиком, может зарабатывать на её использовании другими компаниями, а не только считать её статьёй расходов. Модель, купленная по лицензии у внешнего поставщика, такой возможности не даёт в принципе — банк остаётся покупателем чужой технологии, а не владельцем собственной.
Из чего складывается стоимость пути с нуля
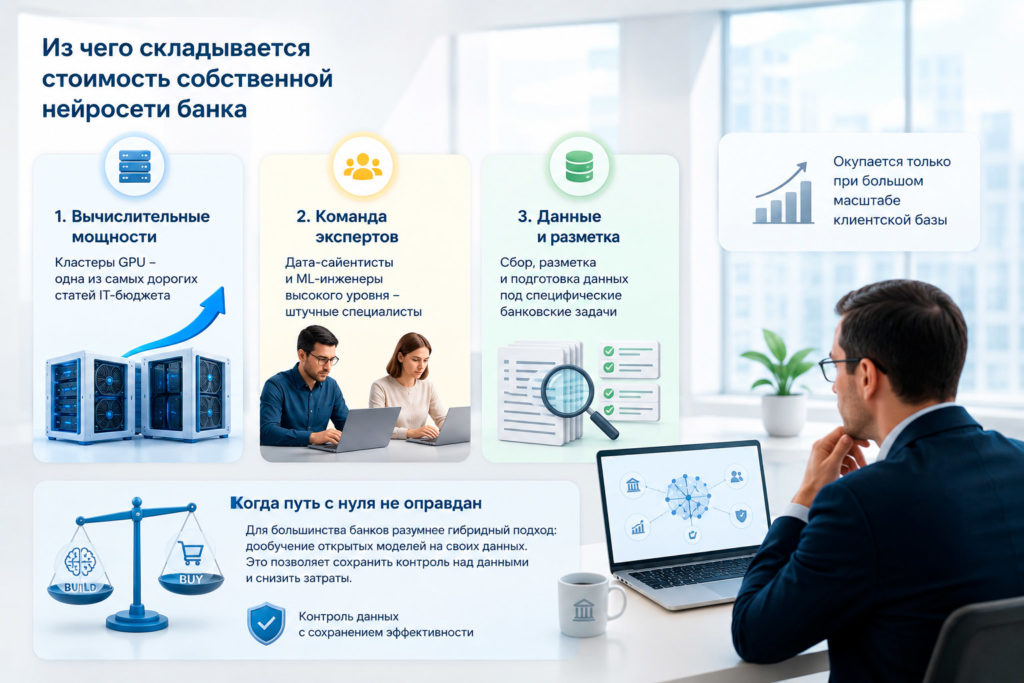 Банки почти никогда не раскрывают точный бюджет разработки собственной модели, но структура затрат в целом понятна из отраслевой практики. Три статьи расходов формируют основную часть стоимости.
- Первая — вычислительные мощности. Обучение большой языковой модели требует кластеров специализированных процессоров, аренда или покупка которых остаётся одной из самых дорогих статей IT-бюджета любой компании, работающей с генеративным ИИ, независимо от отрасли.
- Вторая — команда. Дата-сайентисты и ML-инженеры такого уровня, который нужен для обучения модели конкурентного качества, — штучные специалисты с зарплатами, ощутимо превышающими средние по IT-отрасли, и банкам приходится конкурировать за них не только друг с другом, но и с технологическими компаниями.
- Третья, наименее очевидная статья — данные для обучения и разметки. Модель нужно не только обучить на общих текстах, но и дообучить на специфике конкретных банковских задач, а это требует размеченных данных, подготовка которых также стоит денег и времени.
Именно поэтому путь «с нуля» по силам считаным игрокам на рынке — не потому что технология доступна только избранным, а потому что суммарная стоимость всех трёх статей окупается только при достаточно большом масштабе клиентской базы, на которой можно распределить эти издержки.
Когда путь с нуля не оправдан
 Справедливости ради, разработка собственной модели с нуля рациональна далеко не для каждого банка. Такой путь по силам только игрокам с масштабом, сопоставимым с Сбером или Т-Банком — десятками миллионов клиентов, ресурсами на содержание команды дата-сайентистов и вычислительными мощностями для обучения и дообучения моделей. Для среднего и небольшого банка более рациональной стратегией часто оказывается гибридный подход: дообучение (fine-tuning) уже существующей открытой модели на собственных данных банка, а не построение архитектуры с нуля. Это позволяет частично закрыть требование к контролю данных, не беря на себя полную стоимость разработки базовой модели.
А знаете ли вы, что Т-Банк принял решение отказаться от одной универсальной модели в пользу нескольких узкоспециализированных ещё в конце 2023 года — раньше, чем сама концепция «специализированных ИИ-агентов под конкретную задачу» стала общим местом в отраслевых обсуждениях банковского ИИ.
Похожая логика build-versus-buy применима и к более узкой, но не менее чувствительной задаче — распознаванию клиента по голосу и поведению, где банки также выбирают между собственной разработкой и решением стороннего вендора. Разбираем этот выбор отдельно в материале «как банки используют поведенческую биометрию».
Риски собственной разработки, о которых редко говорят в пресс-релизах
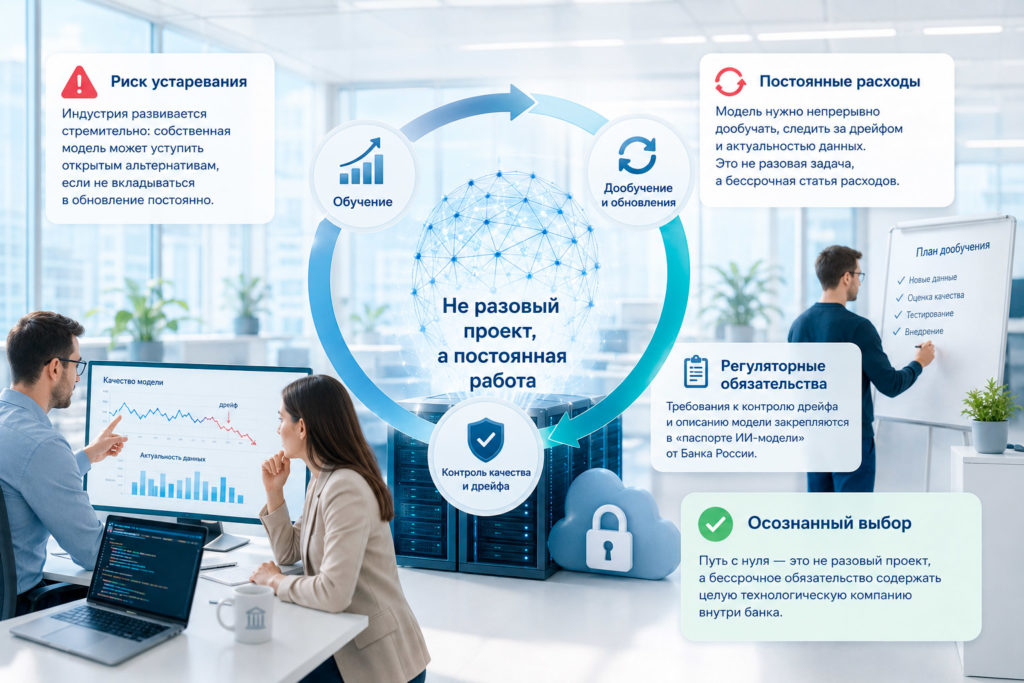
 У пути «с нуля» есть и оборотная сторона, о которой банки предпочитают не распространяться в публичных материалах. Во-первых, это риск устаревания: индустрия открытых и коммерческих моделей развивается настолько быстро, что собственная разработка банка рискует через год-два уступать по качеству бесплатным открытым альтернативам, если банк не готов бесконечно вкладываться в её обновление. Во-вторых, это не разовые вложения, а постоянная статья расходов: модель нужно не просто обучить один раз, а непрерывно дообучать, следить за так называемым дрейфом — постепенным ухудшением качества её ответов по мере того, как меняется реальность, которую она должна описывать. Именно требование к контролю за дрейфом модели заложено и в обсуждаемый Банком России «паспорт ИИ-модели» — то есть содержание собственной модели становится не только техническим, но и регуляторным обязательством банка на постоянной основе.
Это не значит, что путь с нуля — плохое решение. Это значит, что банк, который выбирает этот путь, берёт на себя не разовый проект, а бессрочное обязательство содержать целую технологическую компанию внутри финансовой организации.
Коротко: частые вопросы
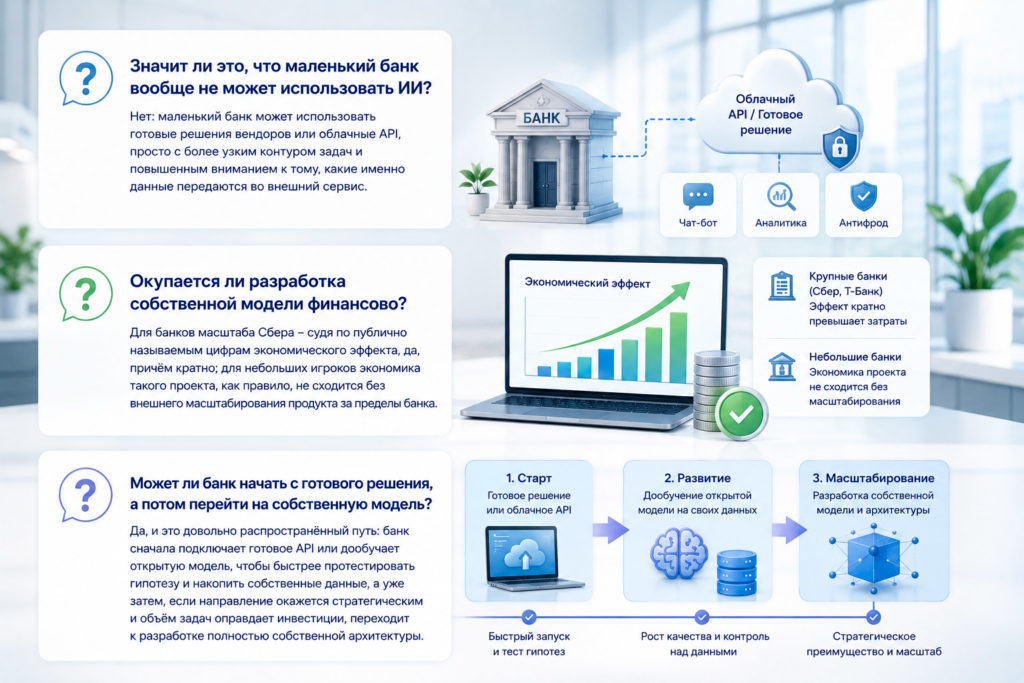
- Значит ли это, что маленький банк вообще не может использовать ИИ? Нет: маленький банк может использовать готовые решения вендоров или облачные API, просто с более узким контуром задач и повышенным вниманием к тому, какие именно данные передаются во внешний сервис.
- Окупается ли разработка собственной модели финансово? Для банков масштаба Сбера — судя по публично называемым цифрам экономического эффекта, да, причём кратно; для небольших игроков экономика такого проекта, как правило, не сходится без внешнего масштабирования продукта за пределы банка.
- Может ли банк начать с готового решения, а потом перейти на собственную модель? Да, и это довольно распространённый путь: банк сначала подключает готовое API или дообучает открытую модель, чтобы быстрее протестировать гипотезу и накопить собственные данные, а уже затем, если направление окажется стратегическим и объём задач оправдает инвестиции, переходит к разработке полностью собственной архитектуры.


